Njohje e modeleve dhe Algoritmave të trajnimit
Modeli "Rule-Based"
Modeli "Rule-Based" merr vendime duke ndjekur një grup rregullash të shkruara paraprakisht
nga ekspertët. Për shembull, nëse një mesazh përmban fjalë ose modele të njohura si
"Kliko këtu", "Fitove një çmim" ose "Verifiko menjëherë llogarinë", sistemi e krahason atë
me rregullat ekzistuese dhe vendos nëse mesazhi përbën një sulm të mundshëm. Ky model nuk
mëson nga të dhënat; ai funksionon vetëm mbi bazën e rregullave të programuara, gjë që e
bën të shpejtë, të parashikueshëm dhe lehtësisht të interpretueshëm
(Russell & Norvig, 2021).
Modeli i bazuar mbi "Support Vector Machine (SVM)"
Modeli Support Vector Machine (SVM) mëson nga një koleksion mesazhesh të etiketuara si
"të sigurta" ose "sulm". Gjatë trajnimit, ai shndërron çdo mesazh në një grup
karakteristikash numerike dhe kërkon të ndërtojë një vijë ndarëse (hyperplane) që i ndan sa
më mirë këto dy grupe. Kur analizon një mesazh të ri, modeli kontrollon në cilën anë të
kësaj vije ndodhet ai dhe e klasifikon si normal ose të dyshimtë. Për këtë arsye, SVM
përdoret gjerësisht në filtrimin e spam-it dhe klasifikimin e tekstit
(Cortes & Vapnik, 1995).
Modeli "DistilBERT"
DistilBERT është një model i inteligjencës artificiale që analizon të gjithë fjalinë, jo
vetëm fjalët individuale. Ai lexon tekstin njëkohësisht dhe përpiqet të kuptojë kuptimin që
krijojnë fjalët në kontekst. Për shembull, një fjalë si "bankë" mund të ketë kuptime të
ndryshme, por modeli e dallon kuptimin duke analizuar të gjithë fjalinë. DistilBERT është
trajnuar mbi miliarda fjalë dhe më pas përshtatet me shembuj të sulmeve të inxhinierisë
sociale, duke mësuar modelet gjuhësore që karakterizojnë phishing, pretexting, scareware
dhe forma të tjera manipulimi. Ai ruan performancë të lartë, ndërsa kërkon më pak burime
llogaritëse se modeli origjinal BERT (Sanh et al., 2019).
Modeli "MiniLM"
MiniLM është një model kompakt i bazuar në arkitekturën Transformer, i zhvilluar për të
ofruar një balancë ndërmjet shpejtësisë së përpunimit dhe saktësisë së klasifikimit. Ashtu
si DistilBERT, ai analizon të gjithë fjalinë për të kuptuar kuptimin e saj, duke marrë
parasysh jo vetëm fjalët individuale, por edhe marrëdhëniet semantike dhe kontekstin në të
cilin ato përdoren. Kjo i mundëson të identifikojë modele gjuhësore që lidhen me sulme si
phishing, pretexting, smishing apo scareware, edhe kur formulimi i mesazheve ndryshon.
Gjatë fazës së trajnimit, MiniLM përdor teknikën knowledge distillation, ku një model më i
vogël mëson nga një model shumë më i madh (teacher model). Në vend që të mësojë vetëm
përgjigjen përfundimtare, ai përvetëson edhe mënyrën se si modeli më i madh analizon
marrëdhëniet ndërmjet fjalëve dhe ndërton vendimin e tij. Si rezultat, MiniLM arrin të
ruajë një nivel të lartë saktësie në klasifikimin e tekstit, ndërsa kërkon dukshëm më pak
memorie dhe kohë për inferencë, duke e bërë veçanërisht të përshtatshëm për platforma web
dhe sisteme që duhet të analizojnë mesazhe në kohë reale
(Wang et al., 2020).
Referenca:
Russell, S., & Norvig, P. (2021). Artificial Intelligence: A Modern Approach (4th ed.). Pearson. ISBN 978-0134610993.
Sanh, V., Debut, L., Chaumond, J., & Wolf, T. (2019). DistilBERT, a distilled version of BERT: Smaller, faster, cheaper and lighter. arXiv. https://doi.org/10.48550/arXiv.1910.01108
Song, F., Lei, Y., Chen, S., Fan, L., & Liu, Y. (2021). Advanced evasion attacks and mitigations on practical ML-based phishing website classifiers. International Journal of Intelligent Systems, 36(9), 5210–5240. https://doi.org/10.1002/int.22510
Wang, W., Wei, F., Dong, L., Bao, H., Yang, N., & Zhou, M. (2020). MiniLM: Deep self-attention distillation for task-agnostic compression of pre-trained transformers. Advances in Neural Information Processing Systems, 33, 5776–5788. https://papers.nips.cc/paper/2020/hash/3f5ee243547dee91fbd053c1c4a845aa-Abstract.html
Metodologjia e kërkimit shkencor dhe krijimit të modeleve
1
Përzgjedhja e Dataset-eve
U përzgjodhën dy dataset-e publike të specializuara për klasifikimin e sulmeve të inxhinierisë sociale, të publikuara në Zenodo dhe Mendeley Data. Dataset-et përmbanin kategoritë "Baiting", "Benign", "Phishing", "Pretexting", "Scareware", "Smishing" dhe "Spam".
2
Para-përpunimi ("Pre-processing")
U realizua pastrimi dhe normalizimi i tekstit, duke eliminuar URL-të, karakteret speciale, hapësirat e tepërta dhe elementët që nuk kontribuonin në procesin e klasifikimit. Të dhënat u standardizuan për t'u bërë të përshtatshme për të katër modelet.
3
Ndarja e Dataset-it
Dataset-i u nda në "Training Set", "Validation Set" dhe "Test Set", me qëllim që trajnimi, optimizimi dhe testimi të realizoheshin mbi grupe të ndryshme të dhënash.
4
Përfaqësimi i Tekstit
"Rule-Based" përdori rregulla logjike, "SVM" përdori "TF-IDF", ndërsa "DistilBERT" dhe "MiniLM" përdorën "Tokenization" dhe "Contextual Embeddings".
5
Trajnimi ("Training")
U realizua trajnimi i katër modeleve. Për "Rule-Based" u ndërtua baza e rregullave logjike, "SVM" u trajnua për të identifikuar kufirin optimal, ndërsa "DistilBERT" dhe "MiniLM" iu nënshtruan procesit të "Fine-Tuning".
10
Krahasimi i Modeleve
U realizua analiza krahasuese e performancës së modeleve "Rule-Based", "SVM", "DistilBERT" dhe "MiniLM", duke identifikuar modelin me performancën më të lartë.
9
Gjenerimi i Matricës së Konfuzionit ("Confusion Matrix")
U gjenerua "Confusion Matrix" për secilin model, duke paraqitur klasifikimet e sakta dhe gabimet ndërmjet shtatë kategorive të sulmeve të inxhinierisë sociale.
8
Llogaritja e Metrikave të Performancës
U llogaritën metrikat "Accuracy", "Precision", "Recall", "F1-Score", "Macro Average" dhe "Weighted Average".
7
Testimi ("Testing")
Modelet u testuan mbi "Test Set", i cili përmbante mesazhe që nuk ishin përdorur gjatë trajnimit. Për secilin mesazh u gjenerua klasa e parashikuar dhe u krahasua me etiketën reale.
6
Validimi ("Validation")
U monitorua performanca e modeleve mbi "Validation Set", duke optimizuar hiperparametrat dhe duke reduktuar rrezikun e "Overfitting".
Rezultatet e vlerësimit të modeleve të trajnuara:
Rezultatet e vlerësimit, të paraqitura në Tabelën 1, tregojnë një përmirësim gradual të
performancës nga modelet tradicionale drejt modeleve të avancuara të përpunimit të gjuhës
natyrore. Modeli "SVM" shërbeu si pikënisje e krahasimit, duke arritur një saktësi në
identifikimin e kategorisë së sulmit ("Accuracy") prej 55.14%.
Duke u mbështetur në transformimin "TF-IDF", ai realizoi klasifikimin e mesazheve përmes
analizës së karakteristikave statistikore të tekstit.
Një përmirësim i mëtejshëm u arrit me modelin "Rule-Based", i cili regjistroi një saktësi në
identifikimin e kategorisë së sulmit ("Accuracy") prej 61.71%.
Në vend që të mbështetej vetëm në karakteristikat statistikore të tekstit, ai integroi rregulla
logjike dhe fjalë kyçe të përcaktuara nga ekspertët, duke përmirësuar identifikimin e modeleve
të njohura të sulmeve të inxhinierisë sociale.
Përmirësimi më i dukshëm u arrit me modelet gjuhësore "MiniLM" dhe "DistilBERT", të cilat
analizojnë jo vetëm fjalët individuale, por edhe kuptimin e tyre në kontekst. Falë arkitekturës
"Transformer", këto modele arrijnë të interpretojnë marrëdhëniet semantike ndërmjet fjalëve dhe
të dallojnë më mirë mesazhe që kanë formulime të ngjashme, por përfaqësojnë kategori të
ndryshme sulmesh. Si rezultat, "MiniLM" arriti një saktësi në identifikimin e kategorisë së
sulmit ("Accuracy") prej 76.00%, ndërsa "DistilBERT" regjistroi
performancën më të lartë me 81.43%.
E njëjta prirje vërehet edhe në matricat e konfuzionit. Tek modelet "MiniLM" dhe "DistilBERT",
numri i klasifikimeve të sakta në diagonalen kryesore është dukshëm më i lartë, ndërsa gabimet
ndërmjet kategorive reduktohen. Kjo tregon se aftësia për të kuptuar kontekstin e gjuhës
përmirëson ndjeshëm saktësinë e klasifikimit ("Accuracy"), duke mundësuar identifikimin më të
besueshëm të kategorisë së sulmit për çdo mesazh të analizuar.
Tabela 1. Krahasimi i performancës së modeleve "SVM", "Rule-Based", "MiniLM" dhe "DistilBERT"
bazuar në metrikat kryesore të vlerësimit ("Accuracy", "Precision", "Recall" dhe "F1-Score")
mbi të njëjtin dataset testimi me mesazhe të etiketuara në shtatë kategori të sulmeve të
inxhinierisë sociale.
| Modeli |
Accuracy |
Precision (Macro Avg.) |
Recall (Macro Avg.) |
F1-Score (Macro Avg.) |
| "SVM" |
55.14% |
56.48% |
55.14% |
52.43% |
| "Rule-Based" |
61.71% |
66.94% |
61.71% |
61.91% |
| "MiniLM" |
76.00% |
79.72% |
76.00% |
76.56% |
| "DistilBERT" |
81.43% |
84.06% |
81.43% |
81.77% |
Matricat e Konfuzionit, të gjeneruara gjatë vlerësimit të modeleve ("Evaluation Phase")
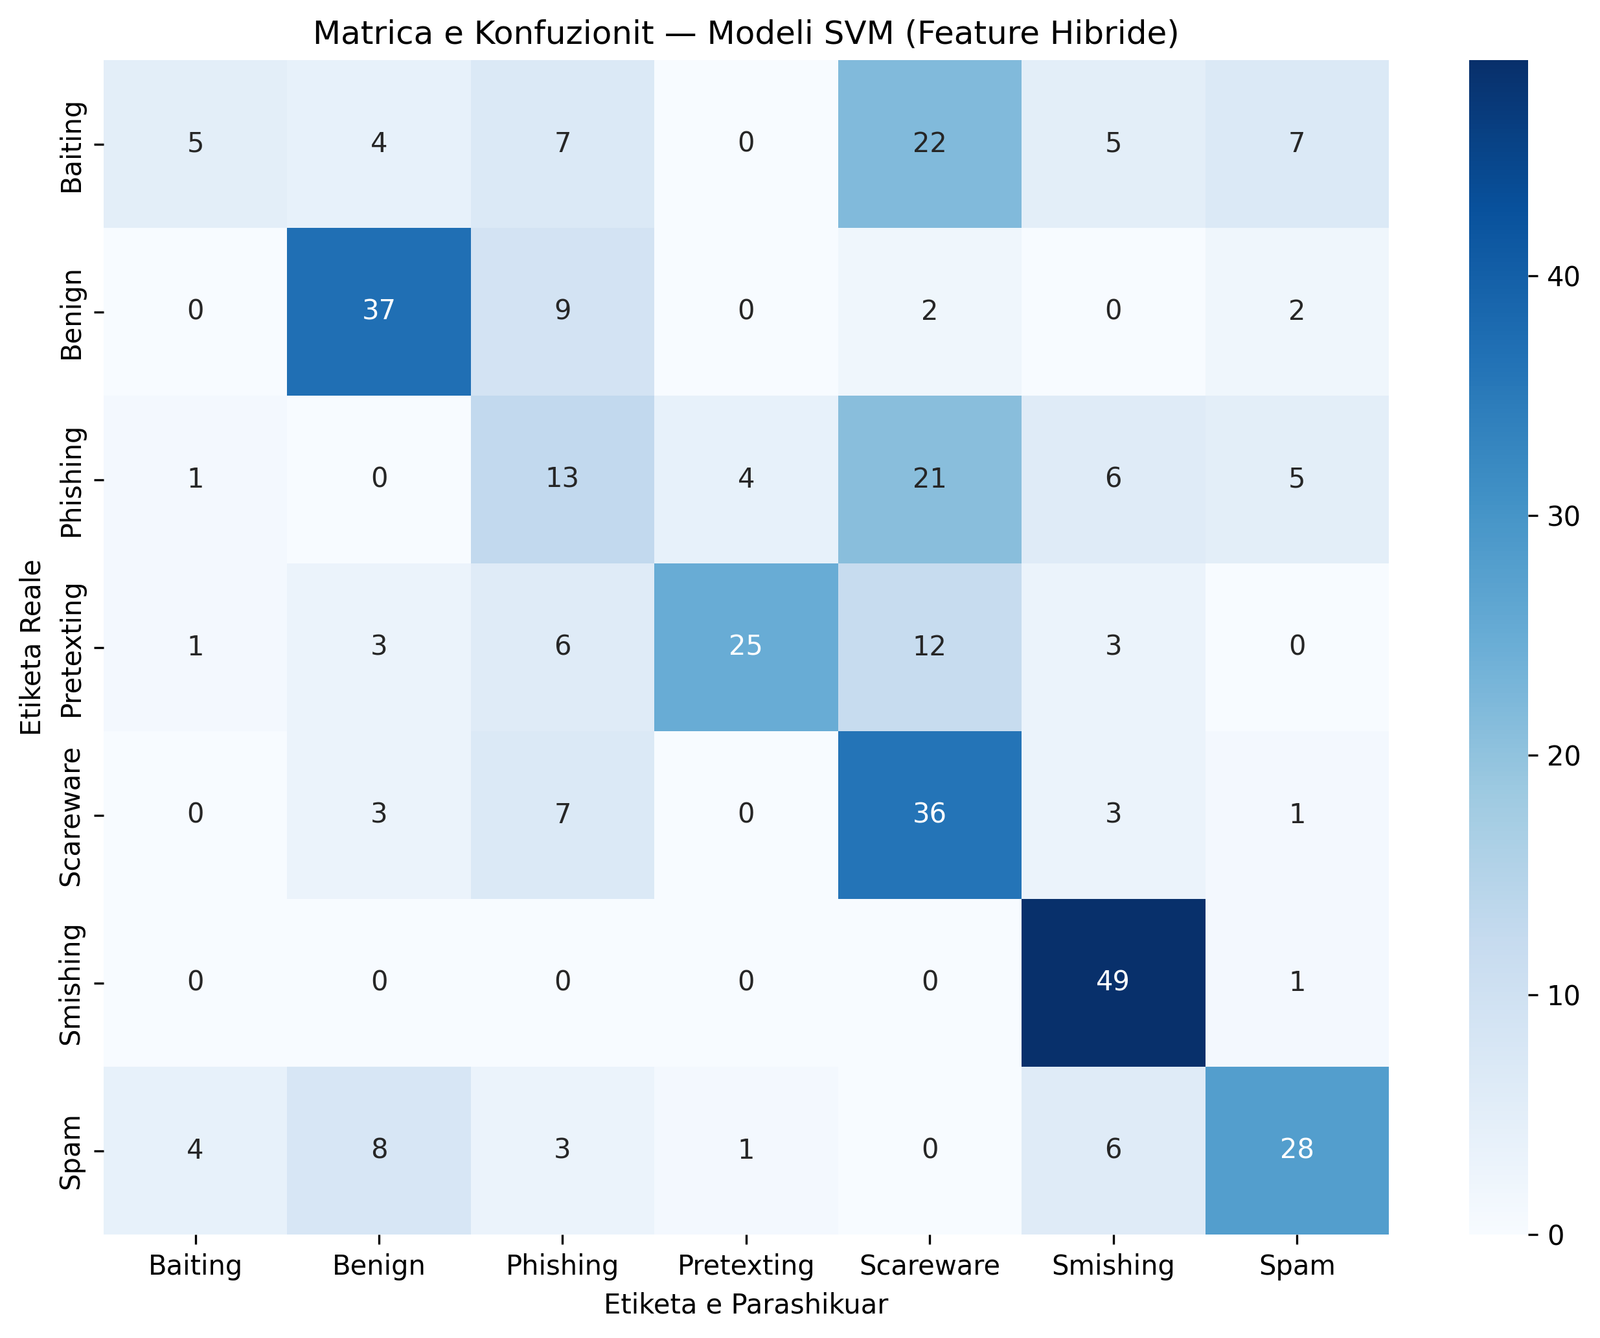
Matrica e Konfuzionit e gjeneruar, gjatë vlerësimit të modelit të trajnuar me algoritmin "SVM"
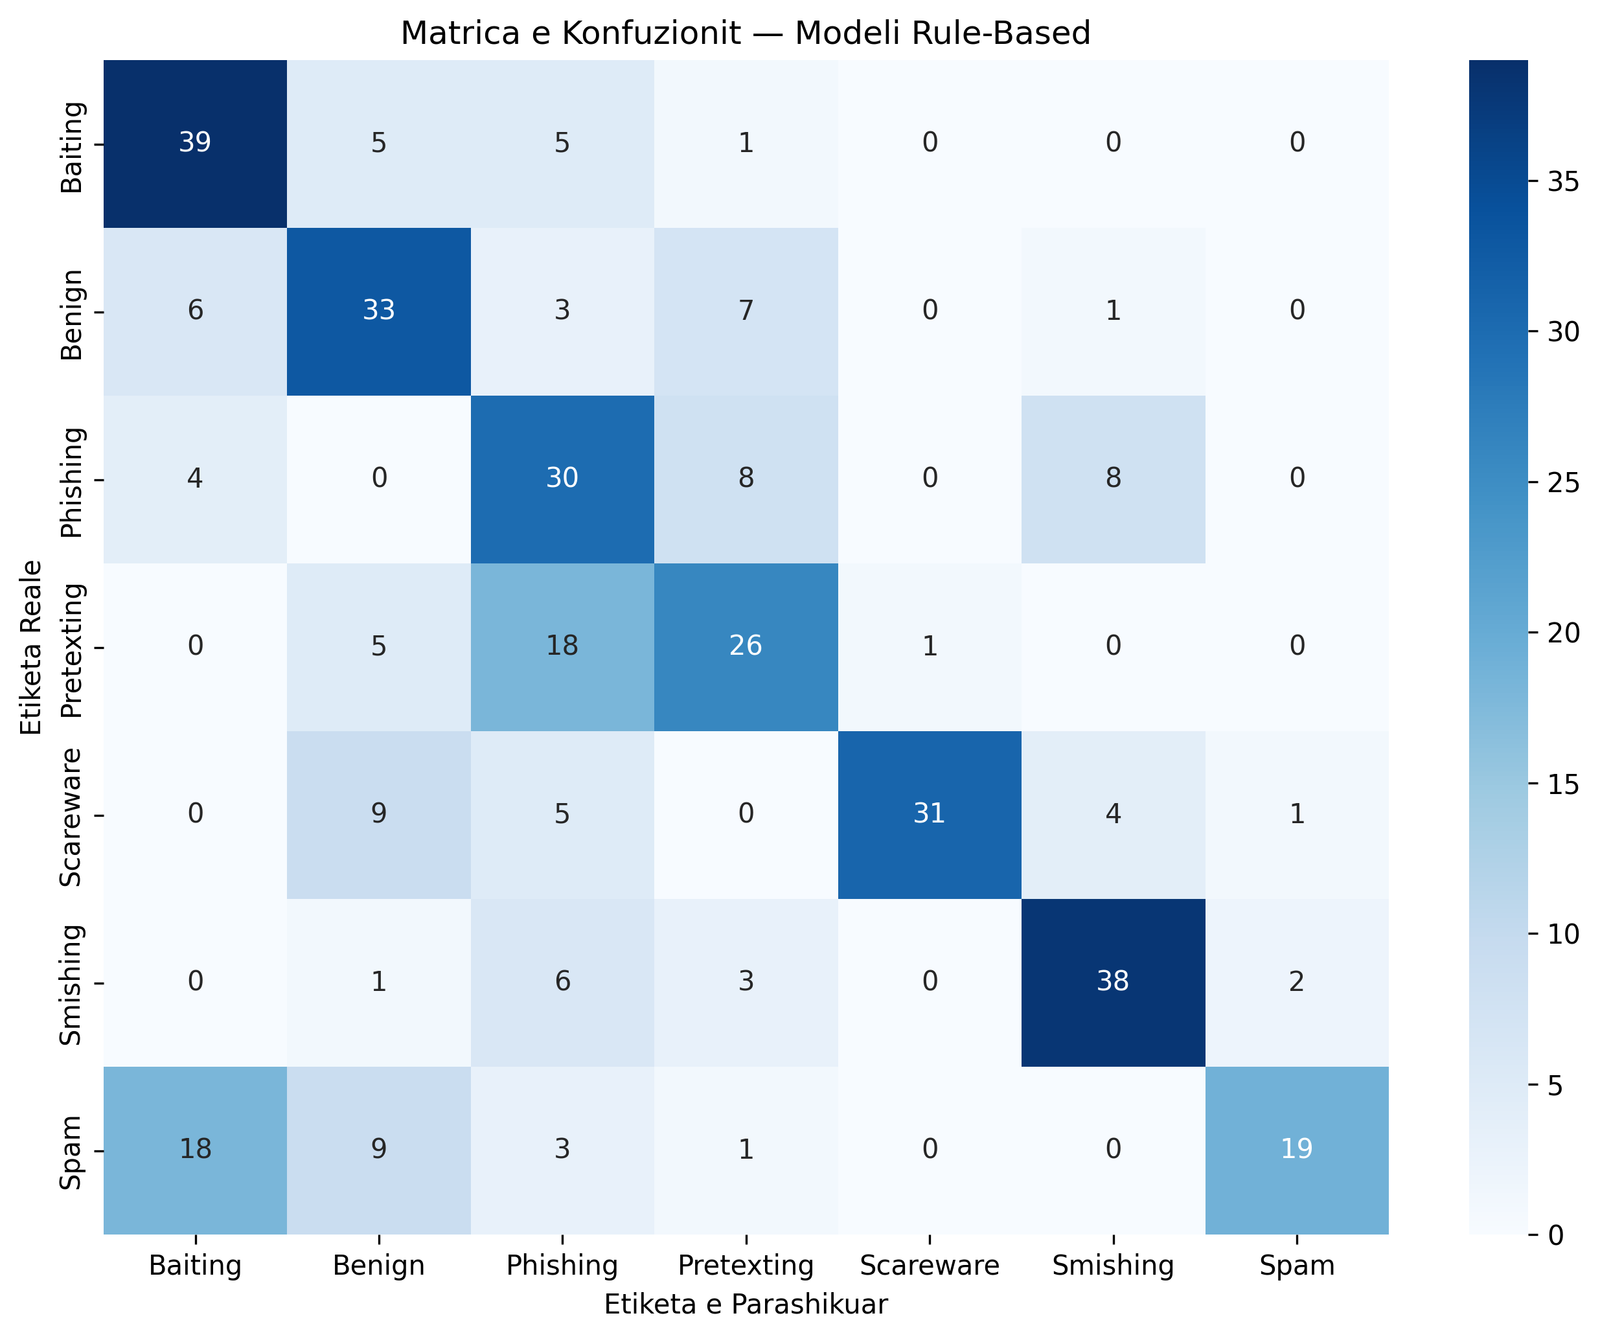
Matrica e Konfuzionit e gjeneruar, gjatë vlerësimit të modelit të trajnuar me algoritmin "Rule-Based"
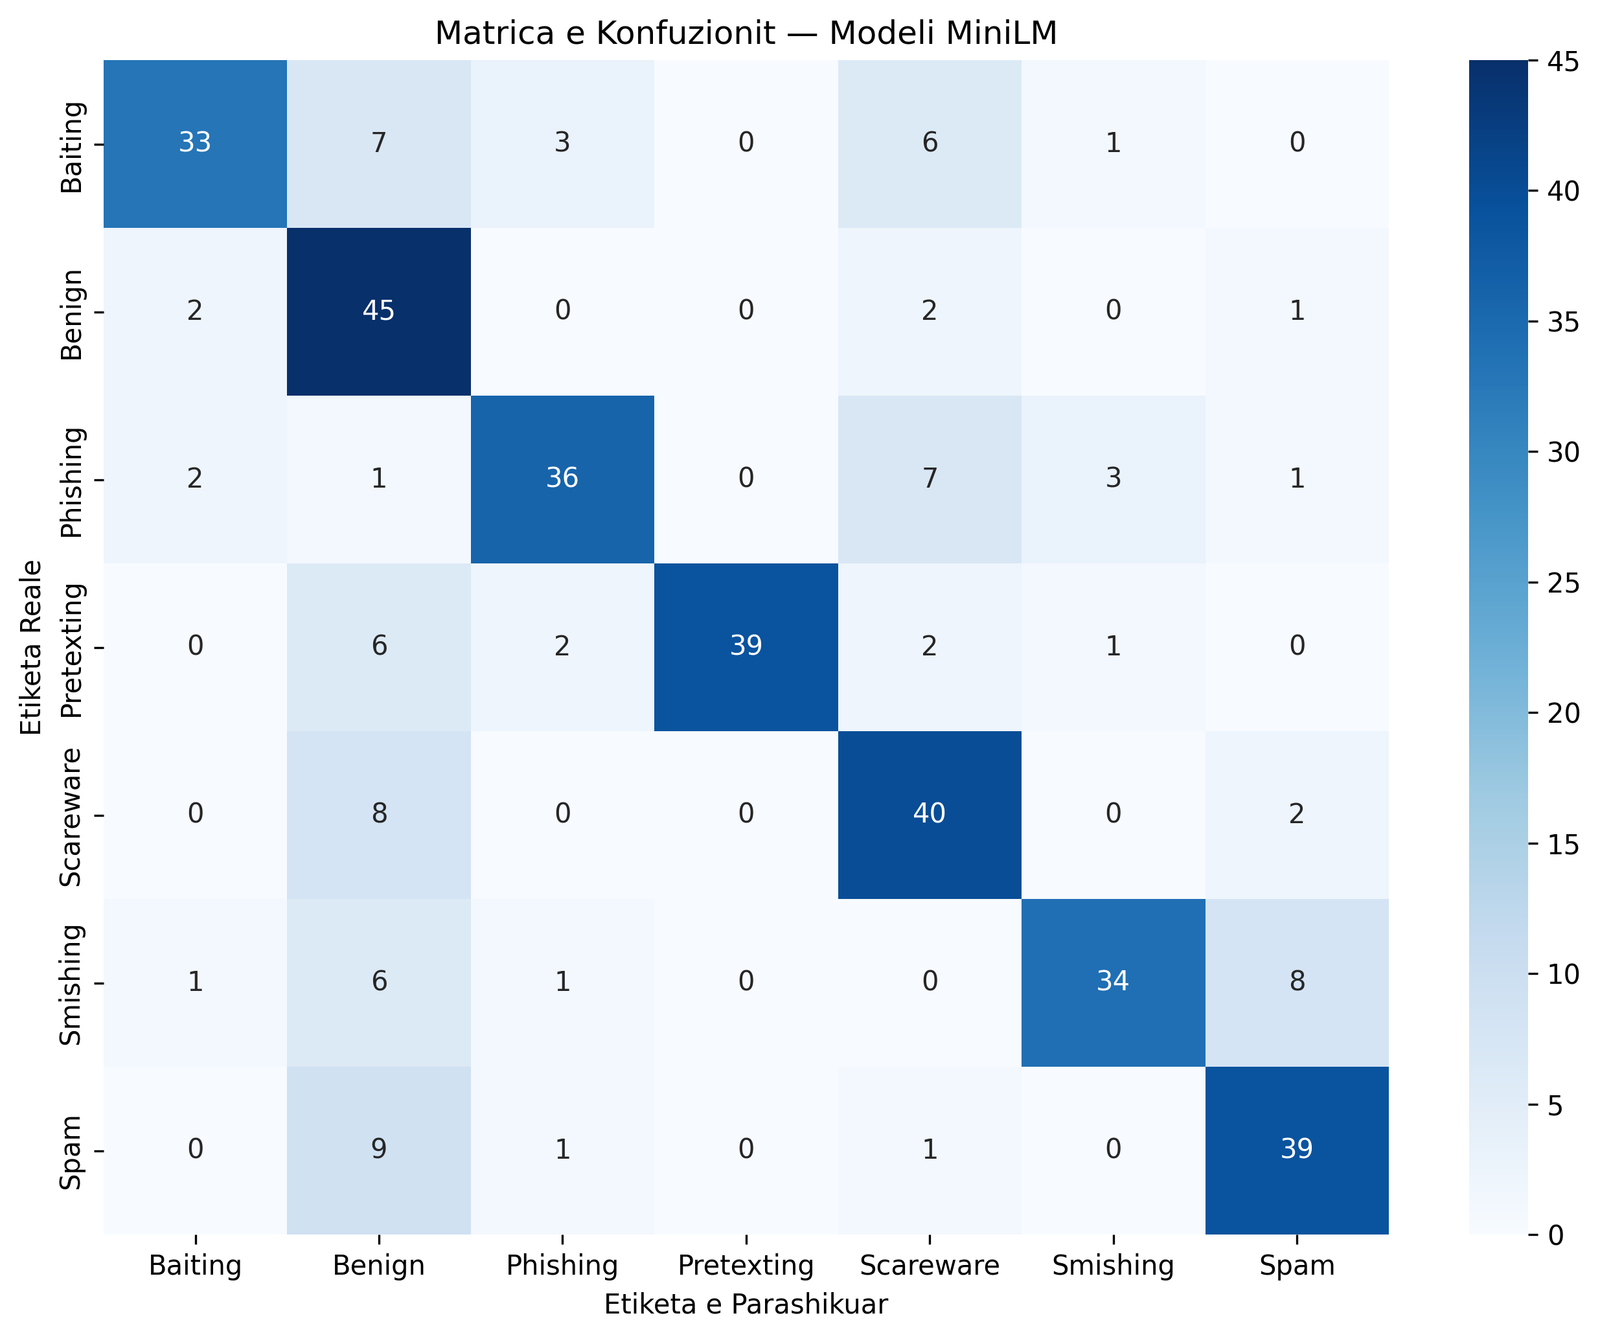
Matrica e Konfuzionit e gjeneruar, gjatë vlerësimit të modelit të trajnuar me algoritmin "MiniLM"
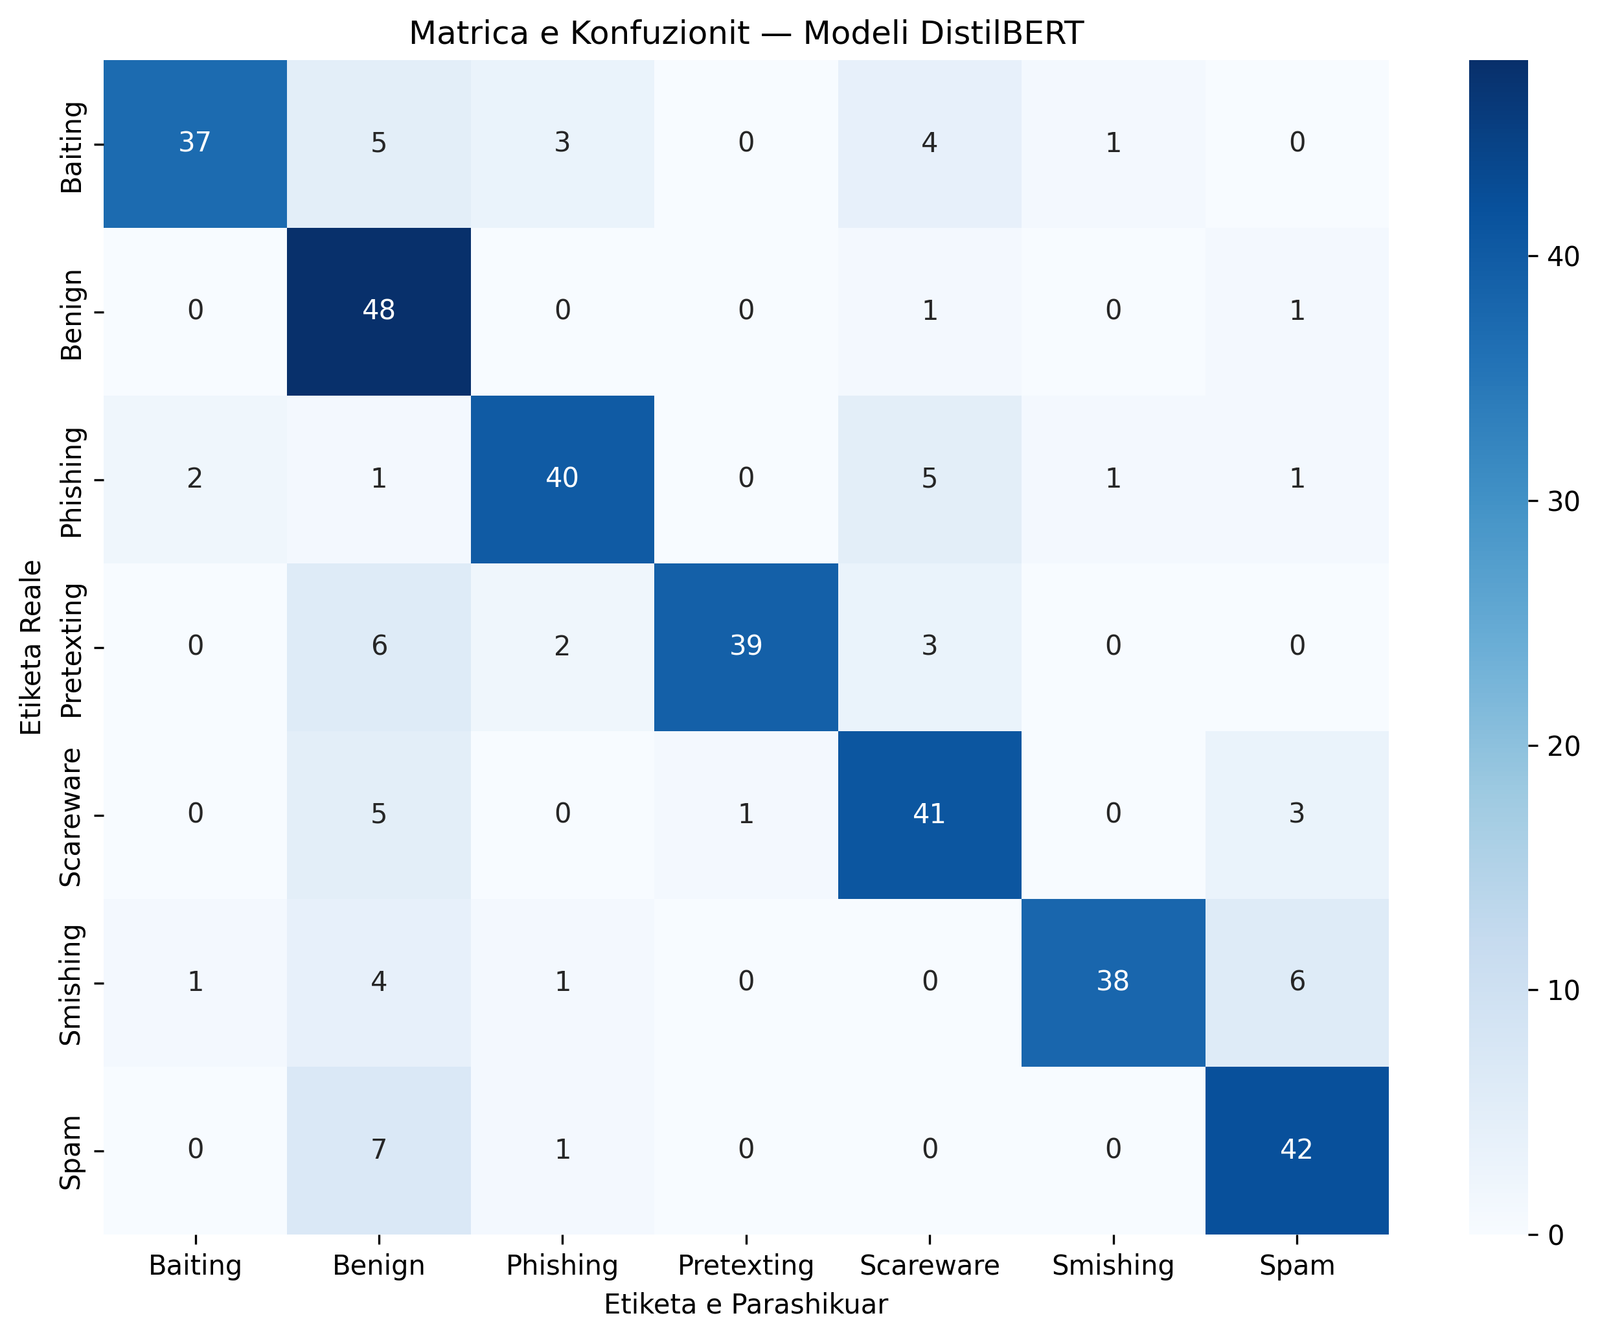
Matrica e Konfuzionit e gjeneruar, gjatë vlerësimit të modelit të trajnuar me algoritmin "DistilBERT"
Tek modelet "MiniLM" dhe "DistilBERT" diagonalia kryesore e matricës së konfuzionit është më e
theksuar, ndërsa numri i klasifikimeve të gabuara ndërmjet kategorive është më i ulët. Kjo
tregon se analiza e kontekstit gjuhësor ndihmon në identifikimin më të saktë të tipologjisë së
sulmit dhe, si rrjedhojë, në rritjen e saktësisë së përgjithshme të klasifikimit ("Accuracy").
Drejtime kërkimore në të ardhmen:
Rezultatet e arritura në këtë projekt krijojnë një bazë të qëndrueshme për zgjerimin e
veprimtarisë kërkimore në AI Data Center-in e Universitetit "Fan S. Noli". Katër modelet e
zhvilluara dhe infrastruktura e ndërtuar mund të shërbejnë si pikënisje për trajnimin dhe
vlerësimin e modeleve të reja të inteligjencës artificiale, të orientuara jo vetëm drejt
identifikimit të sulmeve të inxhinierisë sociale, por edhe drejt zbulimit të kërcënimeve të
tjera kibernetike, si malware, ransomware, "fake news", përmbajtjet e gjeneruara nga
inteligjenca artificiale ("AI-generated content") dhe aktivitetet anormale në rrjetet
kompjuterike.
Një drejtim tjetër kërkimor konsiston në zgjerimin e dataset-eve me mesazhe në gjuhën shqipe
dhe në gjuhë të tjera të rajonit, duke krijuar koleksione të standardizuara që mund të
përdoren nga studiues dhe studentë në eksperimente të mëtejshme. Paralelisht, infrastruktura e
AI Data Center-it mund të mbështesë krahasimin e modeleve të reja gjuhësore, si "DeBERTa",
"RoBERTa", "ModernBERT", "Llama" apo modele të tjera të bazuara në arkitekturën "Transformer",
duke analizuar performancën, kohën e inferencës dhe kërkesat për burime llogaritëse në skenarë
të ndryshëm.
Në planin afatgjatë, AI Data Center-i mund të shndërrohet në një laborator të përhershëm
kërkimor, ku studentët e programeve "Bachelor", "Master" dhe doktorantët të zhvillojnë,
testojnë dhe krahasojnë modele të inteligjencës artificiale mbi të dhëna reale. Kjo do të
krijonte një ekosistem të qëndrueshëm për zhvillimin e projekteve kërkimore, publikimeve
shkencore, bashkëpunimeve me institucione kombëtare dhe ndërkombëtare, si dhe për integrimin e
vazhdueshëm të rezultateve të kërkimit në procesin mësimor. Në këtë mënyrë, vitalizimi i AI
Data Center-it nuk do të kufizohej vetëm në infrastrukturën teknologjike, por do të shoqërohej
edhe me krijimin e një mjedisi aktiv kërkimor, ku modelet, dataset-et dhe rezultatet do të
përditësohen vazhdimisht në përputhje me zhvillimet më të fundit në fushën e inteligjencës
artificiale dhe sigurisë kibernetike.